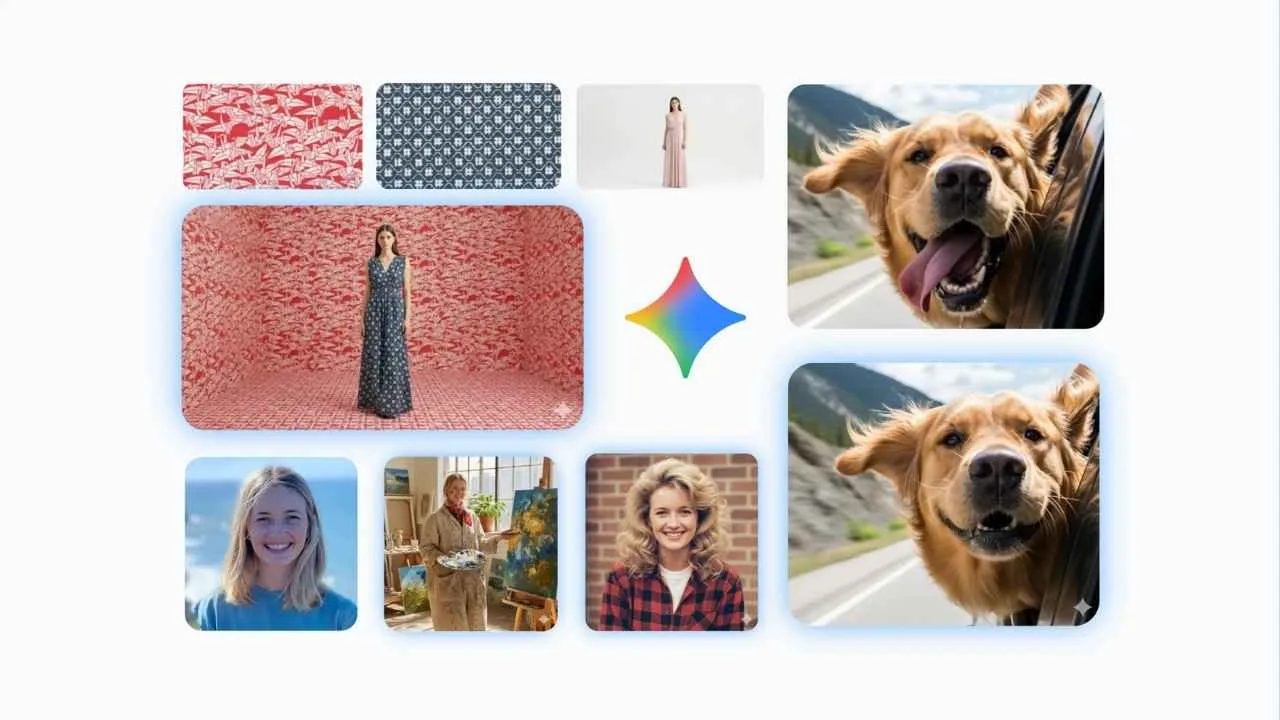
Google a mis à jour le modèle de production d’images et d’édition via le dialogue avec Nano Banana 2.1. Extension de Nano Banana 2, ce modèle met l’accent sur la cohérence des personnages, le respect des commandes et la génération du texte présent dans les images. Le document développeur, mis à jour le 6 octobre, répertorie cette nouvelle version sous le code gemini-nano-banana-2.1.
Le modèle prend en charge l’utilisation d’un maximum de 14 images de référence lors d’une seule génération. Par ailleurs, Google précise sa capacité à préserver l’apparence de quatre personnages et les caractéristiques de dix objets. Cette prise en charge offre aux développeurs qui souhaitent réutiliser le même personnage dans des scènes différentes davantage d’orientations utiles; elle ne garantit pas une correspondance parfaite à chaque résultat.
Du côté des sorties visuelles, des résolutions de 1K, 2K et 4K sont disponibles, la valeur par défaut restant à 1K. De plus, le modèle vise à réduire l’apparence répétitive des segments larges et panoramiques. Google précise notamment les ajustements à opérer pour les sorties en 2K et 4K dans les formats d’aspect 1:4, 4:1, 1:8 et 8:1.
Nano Banana 2.1 améliore également la génération de texte et l’organisation des infographies dans les images. En revanche, une meilleure production de texte par le modèle ne suffit pas à démontrer à elle seule que le contenu établi est factuellement correct. L’utilisateur continue à vérifier que les chiffres, les étiquettes et les légendes présents dans l’image proviennent bien de sources appropriées.
Nano Banana 2.1 étend les options de production et d’édition
Les développeurs peuvent régler le niveau de réflexion sur minimal, moyen (medium) ou élevé (high). Google utilise par défaut le niveau moyen. Par ailleurs, une production assistée par des recherches sur le web et sur l’image permet au modèle d’exploiter des connaissances externes et le contexte visuel; cette fonction n’offre pas les mêmes capacités qu’une recherche de fichiers standard.
La fiche technique de Google pour le modèle complète le cadre technique et les informations d’évaluation de la version. Le document développeur répertorie les entrées sous forme de texte, d’image, de vidéo et de PDF, ainsi que les sorties d’images et de texte. En revanche, la production audio, l’API en direct, l’exécution de code et l’invocation de fonctions ne figurent pas parmi les capacités prises en charge.
La limite d’entrée est fixée à 131 072, et la limite de sortie à 32 768 tokens, précise-t-on. Ces chiffres décrivent les limites de contexte et de réponse du modèle; ils ne reflètent pas directement le nombre d’images pouvant être générées. Par ailleurs, le support Batch API offre aux développeurs qui souhaitent traiter des tâches en lot via un flux de traitement séparé une option.
Google présente le modèle comme la continuité de son approche axée sur la rapidité et l’efficacité des coûts au niveau Flash. Toutefois, le coût d’utilisation dépend du type de sortie et de la tarification de l’API, et il n’en résulte pas un tarif fixe unique. La nouvelle version propose notamment des mises à jour techniques destinées à travailler avec des références et à préserver l’intégrité des visuels au cours de plusieurs cycles d’édition.